

400-820-8531
 图1. 由于质谱的蛋清质组学概括(图源:Shuken, J Proteome Res, 2023)
01.统计数据剖析:多肽鉴定费
单笔LC-MS/MS选用形成的原大统计资料库文件集是一种个大的光谱仪仪数集,不同光谱仪仪常有恢复准确时间、m/z值、承载力和元大统计资料库文件。用于MaxQuant或Proteome Discoverer(Thermo Fisher Scientific)等电脑软件包处置这种大统计资料库文件,转化成肽和/或蛋清质详细信息,不同快速精确常有个成绩排名。大部份数非靶点的自下而上的DDA蛋清质组学实验性中选用的最易见的肽评定策略为大统计资料库文件库搜索网页(图2)。
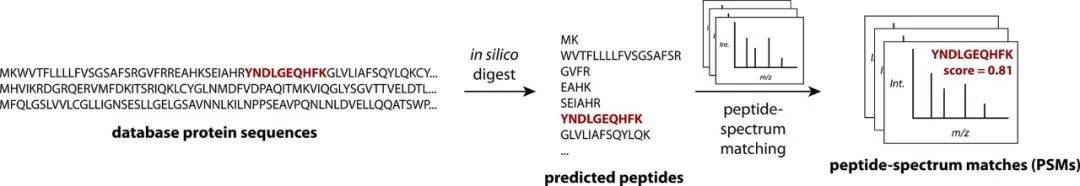 图2. 比对数据库库手机搜索的减化概况(图源:Shuken, J Proteome Res, 2023)
 图3. 小鼠Hexokinase-1的核苷酸回文序列(图源:Shuken, J Proteome Res, 2023)
 图4. 情节m/z值、带引用的MS2谱,甚至图3中出色展示的情节队列(NILIDFTK)
1.1 数据分析库浏览算法流程图范例:SEQUEST的简化法阐述
SEQUEST是199历经四年出版业的第一家全自動肽甄别PC软件。图5操作过程了SEQUEST梯度下降法的简单观念。第两个,对借鉴膳食纤维质组予测的肽采取滤过水,这样可以只要考虑到与区分的损伤铝铁离子的m/z值类似于的前体(即自由电荷环境特喜欢的人肽铝铁离子),然而转换成方法论光谱分析分析分析图仪图分析分析仪分析仪(图5,上方)。借助将调查光谱分析分析分析图仪图分析分析仪分析仪与予测精彩段落的m/z值采取简略十分,方法论光谱分析分析分析图仪图分析分析仪分析仪被加快滤过水,相配精彩段落的总数、MS2抗压难度和别一些基本特征搭配成两个中考结果,仅永久保存来源于该中考结果的前500个方法论光谱分析分析分析图仪图分析分析仪分析仪(图5,过程1)。借助清除前体峰,将光谱分析分析分析图仪图分析分析仪分析仪分割为多个完全雷同的部位,并将每次部位的抗压难度归一改成雷同的值来修改调查光谱分析分析分析图仪图分析分析仪分析仪(图5,过程2),这一步一个脚印使调查光谱分析分析分析图仪图分析分析仪分析仪更取决于方法论光谱分析分析分析图仪图分析分析仪分析仪,降低了搭建方法论光谱分析分析分析图仪图分析分析仪分析仪时依赖的可变气门正时残片化使用率的。借助将每次m/z值处的抗压难度相乘并将乘积累加,计算的调查光谱分析分析分析图仪图分析分析仪分析仪与每次方法论光谱分析分析分析图仪图分析分析仪分析仪期间的上下级密切关系(图5,过程3)。
 图5. 细化了原SEQUEST数剧库寻找神经网络算法的措施(图源:Shuken, J Proteome Res, 2023)
1.2 肽鉴定会中的FDR操作
自己应该如何考虑哪几个成绩够高来说实际的ID?近些年就行,最时兴的的方法是 Target-decoy快速寻找(图6)。该期间调整系统SEO脚本问题察觉率(FDR),即被容忍的PSM脚本问题的均匀比列。要在调整FDR的同時大程度可能地检查测量真肽,能够 应用快速寻找成绩和PSM的别的的特点的直线团体(图6)。直线团体中应用的数值{a, b,…}被系统SEO以大程度可能地检查测量真肽,常见应用percolator应用的广州POS机学习成绩汉明距离。于此系统SEO已完成后,大多数高于所需要的FDR对应着阀值的对象配备(列如 ,1%)被留存。你这个过滤器的数据集的FDR又称“系统SEO”FDR。
 图6. Target-decoy快速搜索。PSM=肽谱配比;FDR =误区知道率(图源:Shuken, J Proteome
02.肽段一定量
便捷优质液质色谱在一部分启动期间中持续地将多肽抑尘喷洒到质谱仪中。区别扫码周期公式连续,往往需求3 s或更罕见,光谱仪分析仪造成MS1光谱仪分析;以至于,在便捷优质液质气相色谱柱过柱期间中,前体的MS1峰频繁被观看到频繁,这么多MS1数据统计点一起来转变成色谱峰(图7A)。给定相关的肽,其色谱峰的基本特征,要是位置或折线下文积(AUC),可以选择于测量方式方法肽的相对而言丰度,这被可称非标准记定量分析(LFQ),该方式方法可以选择于区别试品中的用量比。 以便的提升降钙素原检测复现性、样板通量和/或大数据完好性,标示普通机械制剂常用于降钙素原检测同样质谱中的诸多海洋怪物样板。在等等最简单的方案中,不仅有不一的放射性放射性核素造成的肽或其电影细节描写的m/z值不一外,肽被标示为等于的原子核群,另外留存普通机械经营性质,如留存精力、电离性和电影细节描写经营模式。在代谢率标示最简单的方案中,如内部培养出来有机酸稳定的放射性放射性核素标示(SILAC),经由海洋怪物程序将带有重放射性放射性核素的有机酸标示一整个淀粉酶质组。在样板化学合成准备时,将本身“轻”淀粉酶与重淀粉酶融入,如果与MS1光谱仪实行较为(图7B)。在等压法(即重量等于,因此不一的标贴纸具等于的总重量)标示最简单的方案中,如串接重量标贴纸(TMT),肽段在吸收后被标示,如果在LC-MS/MS前组成。一般CID(HCD)为没个海洋怪物样板挥发释放不一的检测结果铁铝离子;经由MS2或MS3扫苗测定检测结果铁铝离子抗压强度,需要判定出较为丰度(图7C)。在应用LFQ,每回程序启用研究研究定量分析其中一个海洋怪物样例;在应用SILAC,每回程序启用一般而言研究研究定量分析两到四个海洋怪物样例;在应用TMT,单次需要研究研究定量分析高达18种不一的海洋怪物样例。
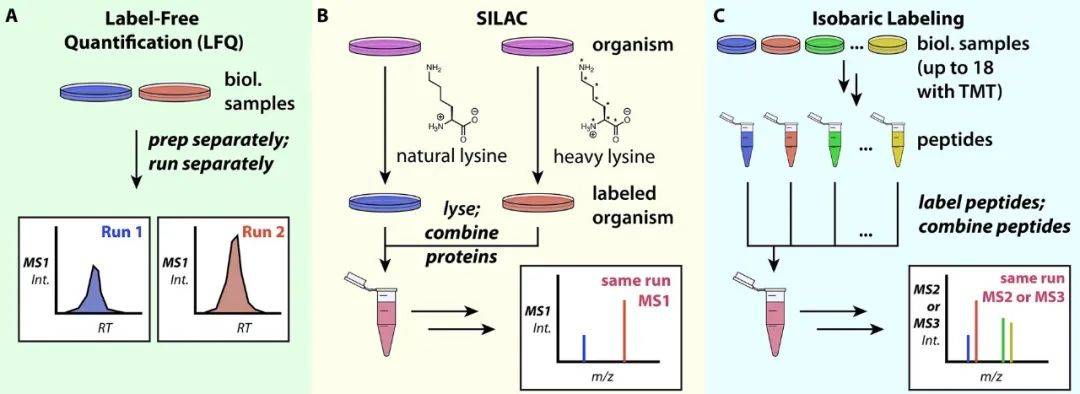 图7. 多肽降钙素原检测工艺。A.在MS1含量采取非标准件记降钙素原检测;B. 组织养育中核苷酸稳定性高拉曼光谱标识(SILAC);C. 等压标识
03.“蛋清质程度”:分析判断蛋清质的性质和丰度
3.1 蛋白酶质推测与分类
或许有些运行自下而上核脂肪酸组学谈起了“核脂肪酸”的真实身份和需求量,但它一般而言是技术鉴定结论和/或程序化核脂肪酸群,其起源地的核脂肪酸或表观遗传或许是不明确化的。相对于这一种前后矛盾,最喜欢见的满足方案设计是运行每个PSM看做原辅料中存有对应核脂肪酸的离婚材料。若组数核脂肪酸当中有相同的离婚材料(即核脂肪酸编码队列与同组数技术鉴定结论的肽编码队列筛选,如图所示8中的核脂肪酸V和VI),则将这一些核脂肪酸组成为一家核脂肪酸组(PG)。若一家核脂肪酸的筛选肽是别的家核脂肪酸的子集,则该核脂肪酸一般而言被是排除在汇报本身,而没有该核脂肪酸应有肽但其肽非是子集的核脂肪酸喻为可涵盖核脂肪酸。
 图8. 蛋白酶质推算和分类方式(图源:Shuken, J Proteome Res, 2023)
3.2 蛋白质水平方向FDR操控
大大部分执行工作核营养素排序的欧美流行电脑软件包,如MaxQuant和Proteome Discoverer,也行来计算核营养素情况技术鉴定FDR的应该,并将其再更改到能接受的情况。有多样办法行操控核营养素情况的FDR。的一种进行的策咯是充分利用耳料PGs,即完全性由耳料PSM构成的的PG,鸟卵被主动留存并因为与总体个人目标PSM是一样的的核营养素测算时。为每一名总体个人目标和耳料PG构筑一名总分,容许以与PSM FDR相似的玩法操控核营养素情况FDR(图6)。3.3核蛋白组按量
多肽和核胆固醇中间有关的各种面影晌到因素使哪一操作过程多样化化。PG内的肽也许 在同旁内角之间适配的核胆固醇中你我各不相同,这也许 会影晌到同旁内角之间的丰度(图8)。倘若PG中的肽是该PG所才有的,那就是有有助于的,充许对单独核胆固醇对其实施细化。当然,多样化的是肽也许 存在于带有翻譯后修饰语的核胆固醇,其丰度影晌到肽的強度,于此,因DDA当下的的随时性,某些肽也许 在一种仿品中检查到而在另个种仿品中检查不来。受欢迎的参数加工游戏包为用户数打造详细了解决某些情况的首选项。基本上都数游戏(以及MaxQuant)只充许对PG-unique肽对其实施化学发光法分析。某些(如Spectronaut ,Biognosys)充许更多的的尺寸,如规定化学发光法分析到核胆固醇特喜欢的人肽,或选泽要不要应用肽強度的中六四位数、和、算数差不多值或是多少呢差不多值来统计PG规模。相对 LFQ,值得购买特别注意的是MaxQuant中达到的受欢迎的MaxLFQ算法为基础。当在各不相同的样板中识別出各不相同的前体集时,MaxLFQ根据按照该用的两两十分和应用中六四位数比例来十分PG来加工缺位值。等压记号和参数自己采集程序(DIA)是减掉或驱除缺位值的一些技术。3.4 总记研究分析和生物体学讲解
已经估算出PG的对于便用量,可根据實驗的生物制品学特质,能否便用各个交通工具对导致完成数值统得解析和释义。Perseus和MSStats是来设计主要用于胆固醇质组便用量完成处理和数值统得解析的2017流行APP包。数值也能否便用代码编程话述(如python或R)自动改手动解析。在通常是比较胆固醇质组学實驗中,分为从目录中快速清理影响物或耳料,便用常用对数使便用量接近正态数据文件分布,将数值归一化以较正启动间的技能进化性,便用数值讲解检测(如t检测/方差解析/直线再战)检测变换,并对导致p值完成多猜测检测。 总算解析来完成后,可是显示会参与微生物工程制品学回答。Gene Ontology是数据分折在测试性性中时有发生改善的微生物工程制品方式的一些最火消息库。STRING供应了业内感欲望的淀粉酶酶质间给定的联系或互不反应的消息。有关解析,如加权平均染色体有关电脑网络数据解析(WGCNA),随着测试性性中淀粉酶酶质丰度变换的类同水平构筑淀粉酶酶质电脑网络数据,这会进十步知晓测试性性中淀粉酶酶质间的的联系。确认全方位的回答这样解析的可是显示,微生物工程制品学假如说会收获的支持或争辩,而且会产生新的假如说。04.拜谱菌物总结报告:质谱事情具体流程
总的说,非标准件记的自下而上的运作流量下面的: (1)分离出来团队/草本花卉、溶水生殖细胞;用磷酸二氢钾和/或去垢剂使淀粉酶质退行。 (2)用DTT或TCEP等手段减低二混炼物;用IAA烷基化半胱氨酸。 (3)用冷甲苯、氯仿-甲醇析出法或磁珠析出法一部分纯化淀粉酶质(部分办公步骤不安全使用有很大危害性的去垢剂如SDS,可跳过去这十步)。 (4)用胰核球胆固醇酶或LysC组合名字核球胆固醇酶消化系统核球胆固醇质。 (5)用C18包被的吸附吸管头抽滤洗掉/脱盐多肽;用真空室抽滤机等挥发石油醚。 (6)将肽重悬于LC-MS兼容的稀释剂中,这类0.1%甲酸水饱和溶液;使用相对的测量仪器步骤开展LC-MS/MS概述;在工作完全后收录原创统计数据。 (7)实用该用的软文包处置最动态数据分析,如MaxQuant或Proteome Discoverer,或软文包的组装,施行动态数据分析库检索、FDR把控好、比较参考值和淀粉酶质判断。 (8)采用java开发语言表达方式(如python或R)或pc软件包(如Perseus或MSStats)强制执行数据概述概述。 (9)按照研究的生态学学原理图来讲解报告;这应该经过途径或网路级定量分析资源英文(如Gene Ontology、STRING或WGCNA)来輔助。 05领先主题活动
拿来DDA参与的非靶向治疗药物自下而上的无符号球血清组,和其他的通过质谱的措施来实验球血清组(图9)。测量仪器和算法为基础均在顺应时代的的更新,完全篇球血清、由上而下和非人工质谱法也适用剖析低复杂化性的样例;球血清的反译后突显而致至关很重要的国家宏观调控用拥有的宽广的实验天。组成部分的球血清组学、无机检查是否球血清组学和说出符号等技术性性安全使用无机检查是否、酶或热技术性性来侦测球血清,为实验球血清组成部分的、无机检查是否、定位手机、球血清-配体互为用或球血清-球血清互为用建立了海量的时机。比较DDA,的统计资料资料自主采摘(DIA)都是种越变越畅销语的采摘措施,最最火的DIA措施是通过SWATH-MS,这之中某个MS1範圍内的所有m/z值在每家扫描软件定期内都其中包含在魂晶中,这远远增强了的统计资料资料完全篇性,增添了球血清组学深入。在靶向治疗药物球血清组学中,一种生活不同的球血清或一组组球血清被为剖析的目的,其目的是保证每天措施启动时都能检侧到目的球血清(的统计资料资料完全篇性好),上限底限地增强敏感度和动态展示範圍,及化学发光法更准性和精密机械度。 对於大总量的球营养素签别和按量,质谱法是现最流行趋势的方式 ,在未来的发展,质谱与别的非质谱枝术的根据使用的都可以更加深入入地学习正个生物制品学中的球营养素组。
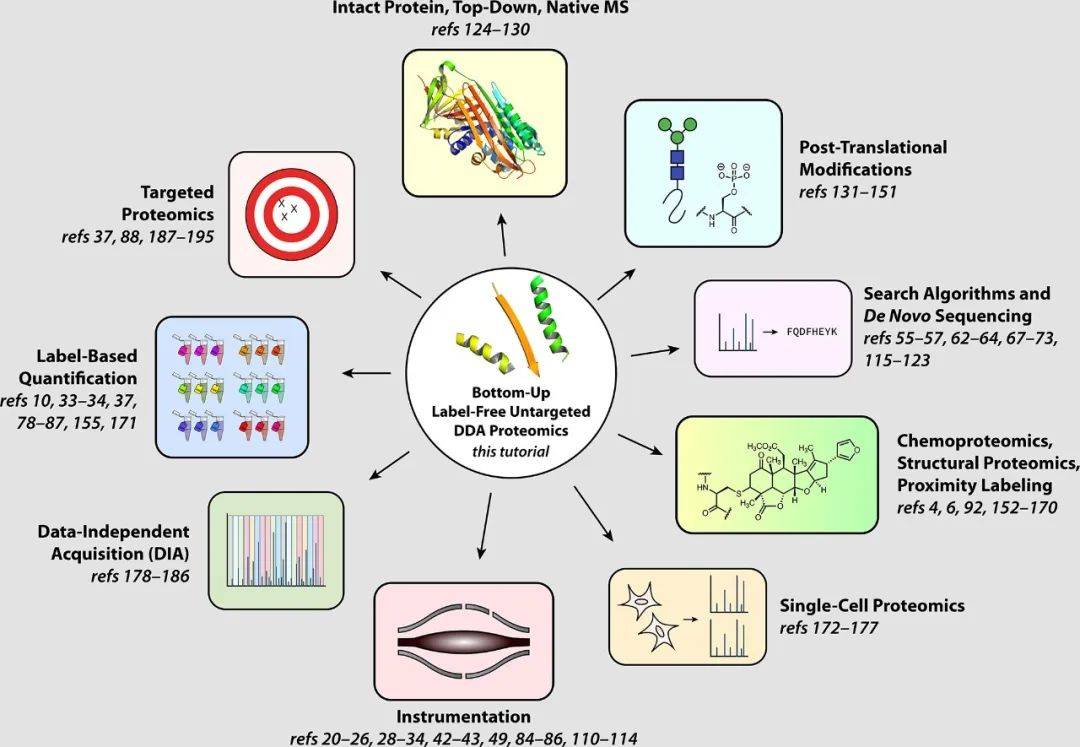 图9. 研究背景质谱的淀粉酶质组学的子前沿技术(图源:Shuken, J Proteome Res, 2023)
基准论文:
Shuken SR. An Introduction to Mass Spectrometry-Based Proteomics. J Proteome Res. 2023; 22(7):2151-2171. doi: 10.1021/acs.jproteome.2c00838.


 观注大学生消费群体号


 关注新闻小丽书


